
一个 List<T>,代码里同时出现了 for、foreach、List.ForEach 和 .Index() 四种遍历。它们都能算出正确结果,速度却能差到五倍以上;其中几种在循环里删元素还会直接抛异常。
结论先给:默认用 foreach;需要索引或者要替换元素时用 for;.NET 9 起想要索引还想保留 foreach 的写法,用 Index();删元素用 RemoveAll 或倒序 for;热点路径且能控制列表生命周期时,用 CollectionsMarshal.AsSpan。Khalid Abuhakmeh 在 .NET 10.0.12 和 .NET 11 RC 1 上把 10、1,000、100,000 条整数各跑了一遍,for 和 foreach 打平,AsSpan 快两成,List.ForEach 慢 1.5 倍,Index() 慢 5.6 倍。
foreach 是默认选项
foreach 最短,不需要管索引,也不只对 List<T> 有效。它按模式编译:只要类型有公开的 GetEnumerator(),枚举器有 MoveNext() 和 Current,就能用 foreach。Span<T> 正是这样被支持的。
List<string> fruits = ["apple", "banana", "cherry"];

foreach (var fruit in fruits)
{
    Console.WriteLine(fruit);
}
几条规则:列表为 null 会抛 NullReferenceException,空列表则循环体一次都不执行;循环变量是只读的,fruit = "mango" 编译不过。要替换元素,得换 for。
break 退出整个循环,continue 跳到下一轮。嵌套循环里 break 只退出最内层。
List<T> 的枚举器是结构体(List<T>.Enumerator),foreach 不会为它分配堆对象,这也是它和手写 for 跑出同样成绩的原因之一。
for 管索引和替换
for (var i = 0; i < fruits.Count; i++)
{
    Console.WriteLine($"{i}: {fruits[i]}");
}

for (var i = 0; i < fruits.Count; i++)
{
    fruits[i] = fruits[i].ToUpperInvariant();
}
用 Count 属性,别用 LINQ 的 Count() 方法。在 List<T> 上两者结果一样,但 Count 读的是一个字段,Count() 要先做类型判断再取同一个字段,白白多一层调用。遍历数组时对应的是 Length。
Index() 是 .NET 9 的新写法
foreach (var (index, fruit) in fruits.Index())
{
    Console.WriteLine($"{index}: {fruit}");
}
元素被包成 (index, item) 元组,可以直接解构。旧版本用 Select 的重载加下标,效果相同:
foreach (var (fruit, index) in fruits.Select((f, i) => (f, i)))
{
    Console.WriteLine($"{index}: {fruit}");
}
它的代价不小:走的是 LINQ 的迭代器,基准里分配 104 字节,10 万条时比 for 慢 5.6 倍。日常代码里用它换可读性没问题,热点循环里别用。
List.ForEach 的限制
List<T> 自带 ForEach(Action<T>),数组和 IEnumerable<T> 上没有,LINQ 也没有。fruits.ForEach(Console.WriteLine) 这种一行写法还算顺手。
但它有三个问题。不能 break,也不能 continue;传 async lambda 时,编译器会把它变成 async void,ForEach 不会等它,方法返回时异步工作还没做完;官方文档还明确写了,在委托里修改列表「不受支持,行为未定义」。
分配则取决于 lambda 是否捕获变量。基准里每轮 List.ForEach 只多出 24 字节,而且 10 条、1,000 条、10 万条三档都是 24 字节,说明这是每次调用创建一次的闭包(lambda 捕获了外层的 sum),和元素数量无关。不捕获变量时不会产生闭包分配;无论捕获与否,每个元素都要多一次委托间接调用,这才是它比 foreach 慢 1.5 倍的主因。
倒着遍历
for (var i = fruits.Count - 1; i >= 0; i--)
{
    Console.WriteLine(fruits[i]);
}

foreach (var fruit in Enumerable.Reverse(fruits))
{
    Console.WriteLine(fruit);
}
Enumerable.Reverse 返回反转后的序列,不动原列表。fruits.Reverse() 调用的是 List<T> 的实例方法,原地反转、返回 void:塞进 foreach 编译不过;单独写一行,数据已经被改掉了。
只要最后一个元素就用索引运算符 fruits[^1]。原文提到 .NET 11 的 JIT 会消除「索引加常量再和长度比较」这类模式的边界检查(形如 i + 常量 < length),对 values[^1] 这种从末尾取索引的写法也会少掉一些冗余检查;不过它的基准里没有用到这些模式。
循环里删元素会抛异常
foreach (var n in numbers)
{
    if (n % 2 == 0)
        numbers.Remove(n); // 下一次迭代时抛异常
}
抛的是 InvalidOperationException,作者机器上看到的文本是「Collection was modified; enumeration operation may not execute.」。文档只描述条件:枚举器创建之后集合被修改。列表内部用版本号检测(Add、Remove 会改动它),枚举器记住进入时的版本,下一次 MoveNext 发现不一致就抛。版本号是实现细节,不是公开契约。
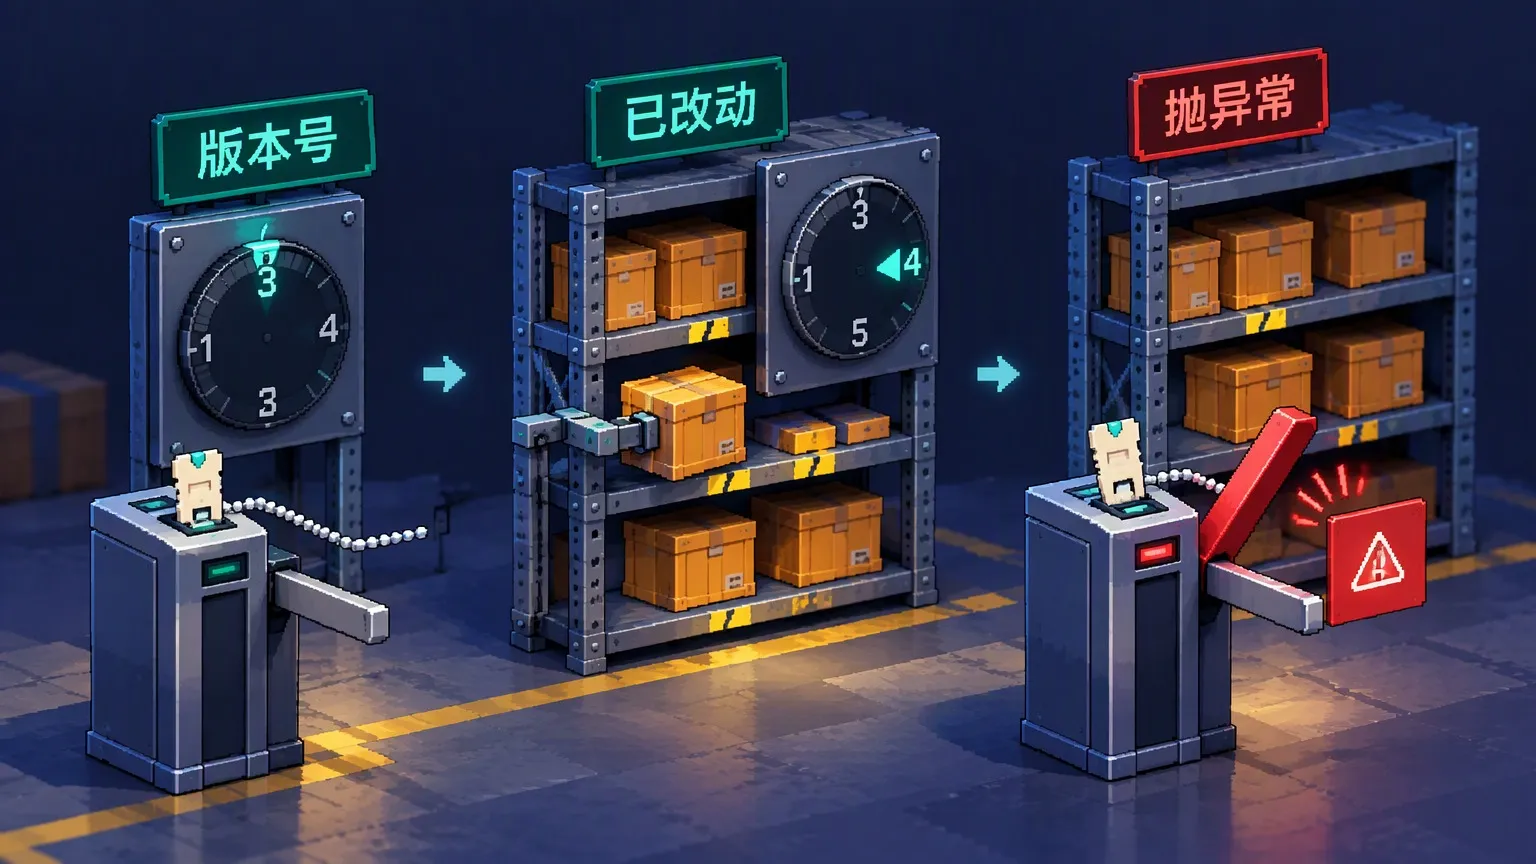
三种处理方式:
// 1. 过滤:一次调用,返回移除的数量
var removed = numbers.RemoveAll(n => n % 2 == 0);

// 2. 倒序 for:删除后后面的元素下移,而下移的元素已经检查过
for (var i = numbers.Count - 1; i >= 0; i--)
{
    if (numbers[i] % 2 == 0)
        numbers.RemoveAt(i);
}

// 3. 遍历副本:多一次分配和整表复制
foreach (var n in numbers.ToList())
{
    if (n % 2 == 0)
        numbers.Remove(n);
}如果只是改元素上的属性,foreach 完全没问题。列表存的是引用类型时,改的是对象本身,列表结构没变。
foreach (var product in products)
{
    product.Price *= 1.1m; // 没问题
}
嵌套列表
List<List<int>> grid = [[1, 2, 3], [4, 5], [6]];

foreach (var row in grid)
{
    foreach (var cell in row)
    {
        Console.Write($"{cell} ");
    }
    Console.WriteLine();
}

foreach (var cell in grid.SelectMany(row => row))
{
    Console.Write($"{cell} ");
}
Span:跳过版本检查
热点路径上,CollectionsMarshal.AsSpan 能把列表的底层数组直接暴露成 Span<T>,枚举器、版本检查全部跳过。
using System.Runtime.InteropServices;

foreach (var score in CollectionsMarshal.AsSpan(scores))
{
    Console.WriteLine(score);
}
Span<T> 还支持按引用遍历,可以原地改元素,包括结构体的字段——普通 foreach 遍历 List<T> 做不到这一点。
List<int> scores = [10, 20, 30];

foreach (ref var score in CollectionsMarshal.AsSpan(scores))
{
    score += 5;
}
代价是安全网没了。文档的要求只有一句:span 使用期间不要往列表里增删元素。从实现看,列表扩容会换掉内部数组,而你手里那个 span 仍指向旧数组,之后读不到新元素、写也写不回列表,而且不会抛任何异常(旧 span 的行为是从实现推得的,文档没有明说)。所以这条只适合你能控制列表生命周期的性能敏感代码。
异步遍历分三种
需要逐条 await,就用 foreach 加 await,一轮做完再做下一轮:
foreach (var url in urls)
{
    var result = await FetchAsync(url);
    Console.WriteLine(result);
}数据本身是异步流(IAsyncEnumerable<T>)时,用 await foreach:
await foreach (var line in ReadLinesAsync())
{
    Console.WriteLine(line);
}
条目之间互不依赖、想并发处理,用 Parallel.ForEachAsync,MaxDegreeOfParallelism 控制同时跑几个,输出顺序不保证:
await Parallel.ForEachAsync(
    urls,
    new ParallelOptions { MaxDegreeOfParallelism = 4 },
    async (url, cancellationToken) =>
    {
        var result = await FetchAsync(url, cancellationToken);
        Console.WriteLine(result);
    });
这三种都不该用 List<T>.ForEach 代替。它接不住 async lambda,循环会在工作完成前就结束。
基准数字怎么读
测试用 BenchmarkDotNet 加 [MemoryDiagnoser],对 10、1,000、100,000 条整数求和,每个运行时一个 job,跑在 Apple M4 Pro 上,对比 .NET 10.0.12 与 .NET 11 RC 1。补一句时点信息:原文发布时(10 月 27 日)最新已经是 .NET 11 RC 3(10 月 25 日),GA 定在 11 月 10 日,作者的数据仍按 RC 1 记录。另外,它的多框架对比配置用了 BenchmarkDotNet 0.13.x 的 CsProjCoreToolchain,最新 0.15.8 已移除这个类型,照抄代码时要注意版本。
下表是 .NET 10 的结果:
| 方法 | 10 条 | 1,000 条 | 100,000 条 | 分配 |
|---|---|---|---|---|
| for | 2.93 ns | 353.6 ns | 34.70 µs | — |
| foreach | 3.20 ns | 351.0 ns | 35.18 µs | — |
| List.ForEach | 6.56 ns | 520.3 ns | 51.93 µs | 24 B |
| Index() | 30.75 ns | 1,949.0 ns | 196.39 µs | 104 B |
| AsSpan | 2.88 ns | 262.8 ns | 27.27 µs | — |
几个结论:
for和foreach在 1,000 条和 10 万条时差距在 2% 以内,挑好读的那个就行。AsSpan在 1,000 条以上快 21% 到 26%,因为它直接在底层数组上循环,少了List<T>索引器那层检查和调用。List.ForEach慢约 1.5 倍:每个元素多一次委托间接调用,闭包只分配一次(24 字节)。Index()慢约 5.6 倍,104 字节的分配来自 LINQ 迭代器。- .NET 11 RC 1 与 .NET 10 的差距在 4% 以内;10 条时
for、foreach慢了几纳秒,到 1,000 条就消失,不值得为它改代码。
这些是作者在一台机器上跑出来的数字,换 CPU、换运行时、换数据类型(比如引用类型列表)结果都可能变。它的价值是给出量级和顺序,不是让你照抄结论。
日常怎么选
- 只是读每个元素:
foreach。 - 需要索引或要替换元素:
for。 - 想要
foreach的可读性又需要索引:Index(),别放进热点。 - 循环里删元素:
RemoveAll,或倒序for加RemoveAt,或遍历ToList()副本。 - 能控制列表生命周期的高频路径:
CollectionsMarshal.AsSpan。 - 异步:
foreach+await、await foreach、Parallel.ForEachAsync,别用List.ForEach。
要验证自己项目里的真实差异,最省事的做法是用 BenchmarkDotNet 照上面的形状写一个最小基准:同一份数据、同样三种规模、只保留你实际用到的两三种写法。跑一次比看十篇文章都准。