
上下文工程处理的是一个具体问题:AI 助手执行任务时,每一步应该看到哪些指令、资料、工具和历史记录。长窗口扩大了容量,也让错误假设、无关信息和失败尝试更容易累积。要让能调用工具、持续工作的 AI 助手(agent)稳定推进任务,就需要持续筛选这些信息;当历史开始妨碍判断时,可以保留工作成果,清理或重置对话。
这也是 Drew Breunig 在 2026 年 10 月发表的 The State of Context Engineering 中贯穿的判断:模型越能处理长任务,外围系统就越需要管理信息的进入、保留与退出。重置只是其中一种手段,效果取决于任务、保留的材料和失败原因,不能把某个 token 数或重启周期当成通用规则。
窗口变大,信息仍然需要挑选
上下文窗口决定一次调用最多能容纳多少内容。它不会自动保证这些内容彼此一致,也不会保证模型能从大量历史中选出当前最有用的部分。
Breunig 回顾长上下文兴起时的一种期待:只要窗口足够大,就可以把材料全部交给模型,省去检索和筛选。实际使用暴露了另一面:旧结论可以一直留在对话里,错误示例可以重复出现,不同工具和技能的要求也可能互相冲突。
他把这些问题整理为四类。这个分类适合排查日志,因为每一类都指向不同的检查对象:
| 失败类型 | 可观察的表现 | 优先检查什么 |
|---|---|---|
| 上下文毒化(poisoning) | 后续计划反复依赖一个错误结论 | 这个结论的证据,以及它何时进入待办或摘要 |
| 上下文分心(distraction) | 模型沿用历史做法,忽略当前要求或已有知识 | 旧示例和失败尝试是否占据了大量上下文 |
| 上下文混淆(confusion) | 无关背景影响当前回答 | 检索结果、记忆和用户资料是否适用于本次任务 |
| 上下文冲突(clash) | 指令、工具说明或技能要求互相矛盾 | 哪些规则同时生效,适用范围是否清楚 |
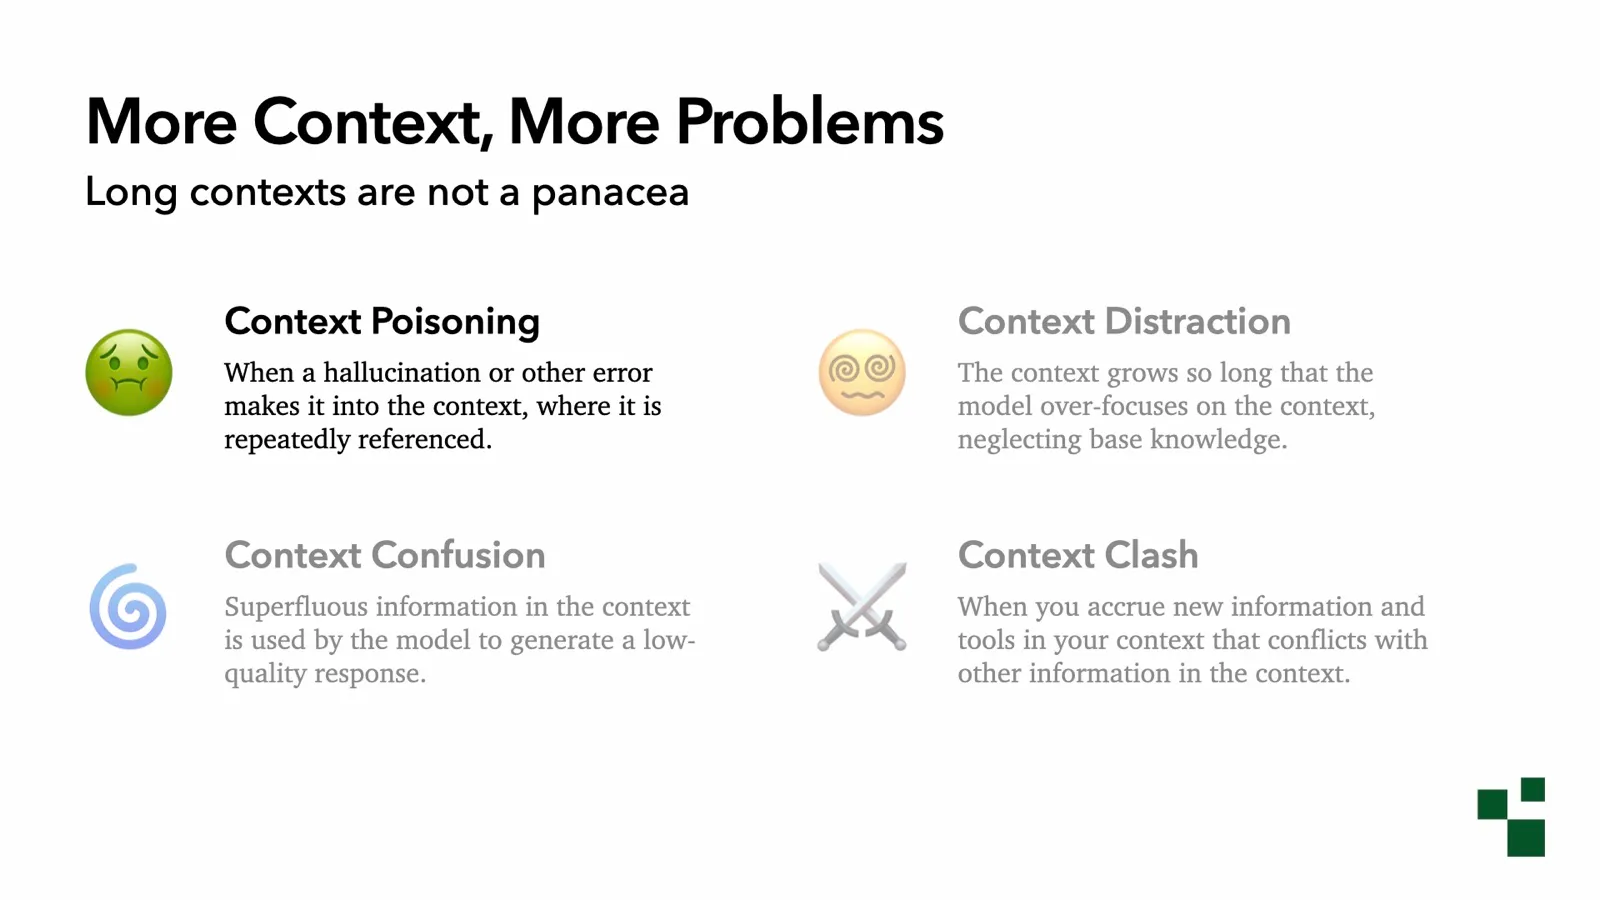
表格最后一列是根据这些定义整理的排查建议。它们可以帮助缩小范围,但单凭一次错误回答,还不能确定具体原因。
毒化尤其容易藏在看似有用的摘要里。演讲引用了 Gemini 玩宝可梦的案例:模型把另一个游戏版本中的取茶任务带进当前计划,随后花费大量时间尝试完成这个错误目标。对软件开发任务也可以提出相同的检查问题:待办清单里的每个前提,究竟来自实际文件和测试结果,还是来自模型先前未经验证的猜测?
历史示例会影响模型如何理解指令
《Do as I Say, Not as I Do》研究了明确指令与历史示例冲突时的模型行为。其中一组实验要求模型把问题翻译成俄语,却在历史里放入法语翻译示例,再观察后续输出。
这些示例没有明确撤销原指令。实验仍发现,随着相反示例增加,模型可能逐渐跟随历史模式;不同模型和任务条件的抵抗能力不同。这说明检查提示词是否写清楚还不够,也需要检查整段上下文展示了怎样的行为。
把这个观察用于编程助手时,要保留实验与实践之间的距离。论文没有直接证明某次 CSS 修改失败来自上下文分心。不过,如果一次调试已经积累了许多错误方案,继续补一句“请严格遵守要求”可能仍然留下大量干扰。
一种可检查的改法是重新整理任务材料:保留当前代码、实际报错和已验证的约束,把已经排除的方案标明原因。这样下一轮至少能区分“试过但失败”与“仍可采用”,不必从整段聊天里重新猜测。
六种手段分别控制信息的进出
Breunig 总结的六种上下文管理手段,覆盖了补充、筛选、隔离和保存信息的不同环节。选择哪一种,应从当前缺少什么或受什么干扰开始。
- 上下文增强(augmentation):通过检索或读取资料,补充当前任务所需的信息。适合模型缺少具体事实、代码或约束的情况。
- 工具装载(tool loadout):只提供相关工具和技能,减少无关说明与选择。工具清单也会占据模型注意力。
- 上下文隔离(quarantine):让子任务从干净的历史开始,按需访问同一工作环境。需要提供足够完整的任务说明。
- 上下文剪枝(pruning):删除当前不再需要的工具输出或历史轮次。应保留仍影响判断的约束和证据。
- 上下文卸载(offloading):把信息保存在文件或数据库中,需要时读取。代码、实验结果和任务状态可以独立于对话存在。
- 上下文压缩(summarization):用简报替代冗长历史。压缩时要区分事实、假设和未决问题,避免把猜测固化成结论。
这些手段可以组合使用。例如,先把完整测试日志保存为文件,再从对话中移除大段输出,只留下失败用例、关键信息和日志路径。需要追查细节时,助手仍能读取原始记录。
组合也有成本。摘要可能遗漏关键条件,筛选可能误删证据,改变上下文前缀可能影响提示缓存的命中。管理上下文时需要同时关注任务结果、恢复信息所需的时间和调用成本。
把管理步骤写进运行程序
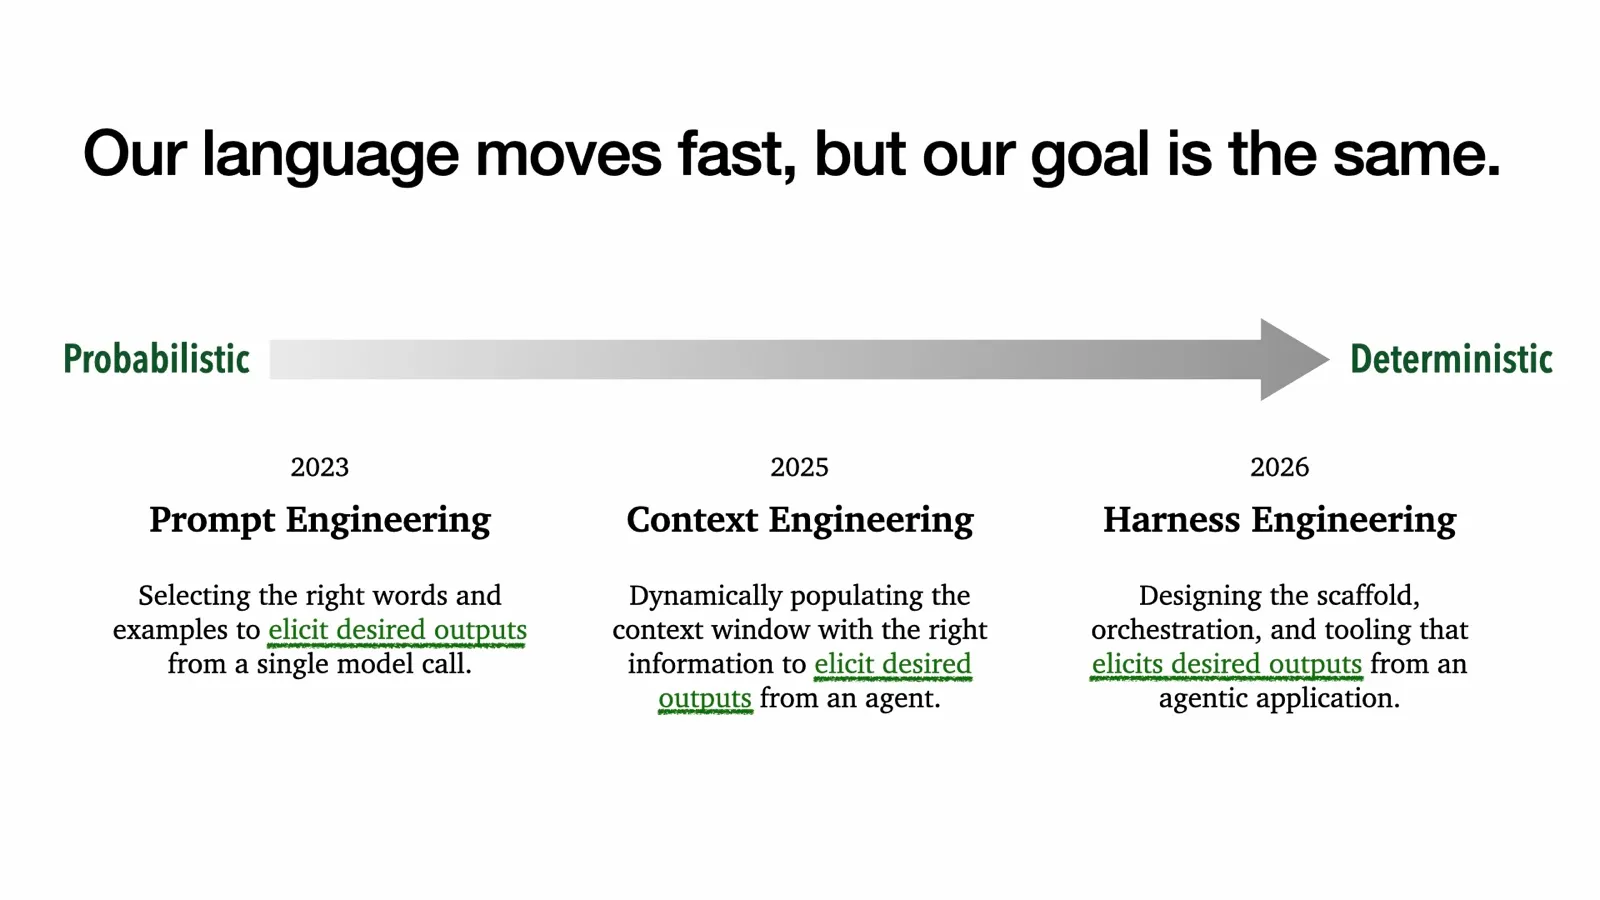
负责调用模型、执行工具、保存状态和安排下一步的外围程序,通常被称为 harness。上下文工程进入这个程序后,信息管理便可以在每次调用前后执行,不必每轮都由用户手动整理。
演讲里的 DSPy 示例展示了这种组织方式:先选择工具,再调用 agent;按需要筛选历史,或者把旧轮次压成简报;可独立执行的子任务则交给干净的上下文。代码示例说明这些动作可以嵌入运行循环,并不代表生产系统只需要几行代码就能处理所有情况。
这里有一个容易混淆的边界:流程写进代码后,流程中的判断仍然可能依赖模型。程序可以规定“每轮调用前执行工具筛选”,但“哪个工具相关”如果交给另一个模型,结果仍可能出错。
对于实际系统,可以先把容易验证的限制写成明确规则,例如工具权限、输出长度和任务预算;需要理解语义的判断再交给模型,并保存选择结果,便于失败时追查。这是对演讲思路的工程应用建议,具体规则仍需用实际任务验证。
Breunig 还提醒,模型在训练中形成的工具使用习惯可能与当前环境不匹配,他称之为“对抗权重”(fighting the weights)。这个解释提示我们检查工具接口与训练习惯的差异,但一次参数错误不足以证明原因就在训练权重。接口说明不清楚、版本不一致或普通推理失误,也需要排查。
长任务为何需要重新开始思考
长时间运行的 agent 可能持续工作,却越来越少尝试新的方向。Breunig 把过度执着于某个假设、子任务或目标的现象称为上下文惯性(context inertia)。
几项研究给出了相关证据,但它们的处理方式和评估环境各有区别。
Anthropic 在介绍 Memento 时记录了一个例子:agent 花了数小时排查包版本,实际问题却是实现的端点与评估接口不兼容。Memento 会定期启动新实例,让它继承工作区和前一个实例留下的简短笔记,以便尝试不同策略。这里保留了工作进度,同时减少旧对话对后续判断的影响。
微软研究院的《Fork-and-Flush》关注自动研究任务。研究发现,同一任务的不同运行可能停留在不同水平,继续投入计算也难以缩小差距。它的方法在特定阶段分出并行探索路径,各路径继承已有工作区,从新的聊天上下文开始,再评估得到的候选方案。这同时涉及重新开始与并行探索,不能把全部收益归给单独一次清空操作。
《Scaling Discovery Requires Forgetting》则研究了持续迭代、并行运行和 agent 之间共享候选方案等方式。作者观察到,历史累积后搜索会趋于停滞;周期性丢弃会话和候选历史,从目前最好的候选重新出发,可以在所测任务中继续推进搜索。
这些结果支持尝试“保留有效产物,减少历史负担”。它们还没有建立适用于所有编码、写作和问答任务的重置规则。复现一个偶发错误可能依赖细致的过程记录,清空前就需要把这些记录保存好。
重置前先留下可接手的状态
Breunig 提到,他在上下文达到二十万到三十万 token 时会开始考虑是否重置。这是个人经验。任务内容、模型和工具输出密度不同,同一个长度可能意味着完全不同的信息负担。
日常使用更值得观察的是进展:助手是否反复提出已经排除的方案,是否持续修改却无法改善结果,是否还在引用已被日志推翻的假设。出现这些现象时,可以安排一次受控的重置,而无需等到窗口填满。
下面是一种根据前述研究整理的操作顺序,适用于工作成果已经能够保存的任务:
- 保存当前代码、文档或最佳候选,以及能够验证它们的命令和结果。
- 写一份接手说明,交代目标、不能改变的约束、已确认事实、未验证假设和下一项待检查问题。
- 将完整日志保存在可读取的位置。简报只保留关键证据与路径,避免重新复制整段聊天。
- 在新的上下文中恢复任务,要求先核对当前产物与关键假设,再决定下一步。
- 用原有测试或评分方式比较重置前后的结果。若仍重复失败,继续检查任务定义、工具接口、环境和模型能力。
接手说明尤其需要审查。假如旧上下文中的错误假设被直接写成“已确认原因”,新会话仍会继承同一个问题。重置只能移除部分历史,无法自动纠正留下的材料。
长期记忆也需要维护
把状态移到文件和记忆系统后,信息仍然可能过时。Breunig 根据自己运行个人 agent 的经历,预测长期积累的技能和记忆会出现矛盾:同一类任务留下多套解决办法,每套都有当时的理由,后来却同时影响新的任务。
这是他对后续问题的判断,不能当作所有长期 agent 都已发生的事实。它给实际维护留下了一个明确问题:一条经验适用于什么条件,什么时候需要重新验证?
对经常使用的技能文件,可以在发现冲突时回到原始任务和证据,保留仍适用的规则,修订已过时的条件。每次失败都追加一条永久要求,会让下一次选择更困难。
下次助手陷入重复试错,可以先保存产物,写清已确认的事实和仍待验证的假设,再用新的上下文检查同一个问题。只有在结果改善后,才有依据把这种做法纳入固定流程;若没有改善,就沿着日志继续查找原因。
参考
- Drew Breunig:The State of Context Engineering(演讲、分类和个人经验的主要来源;原文采用 CC BY-NC 4.0 许可,本文作中文重述并补充实践建议)
- Do as I Say, Not as I Do: Instruction-Induction Conflict in LLMs
- Anthropic:AI models may be capable of self-replicating without access to a datacenter(Memento 的说明)
- Fork-and-Flush: Escaping Idea Basins in Autoresearch Agents
- Scaling Discovery Requires Forgetting