Tag: LLM
All the articles with the tag "LLM".
-
上下文工程的现状:从塞满到遗忘
Published: at 12:45 AM上下文工程要解决的是模型每一步该看到什么、保留什么、忘掉什么。本文结合长上下文的四类失败、六种管理手段与近期研究,说明如何在保留工作成果的同时减少历史干扰,以及何时值得重置对话、何时应继续排查工具和任务本身。
-
Decisions API:更快返回有限答案的判断接口
Published: at 01:13 AMOpenAI Decisions API 面向分类、路由和评分等有限答案任务。本文说明 predicate、choice、score 的差别,给出可运行的工单分诊示例、阈值设置与成本边界。
-
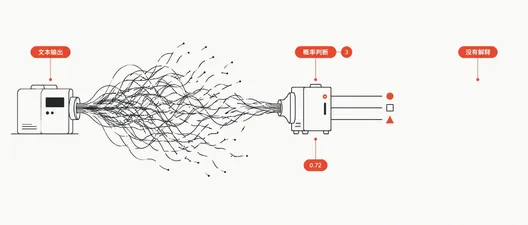
Jev 决策模型:调用方式、成本与边界
Published: at 12:18 AMTypeSafe 的 Jev 只输出带概率的判断而不是文本。核对它的调用方式、每百万 token 0.042 美元的定价,以及官方文档承认的失败模式与提示注入风险。
-
把 LLM Judge 放进 Agent 运行时
Published: at 11:40 PMLLM judge 正从离线评测走进 agent 运行时,开始影响继续、重试、换模型或转人工。本文拆解 7 种架构模式,说明如何拆分判断、比较候选、检查过程,并用确定性逻辑控制风险。
-
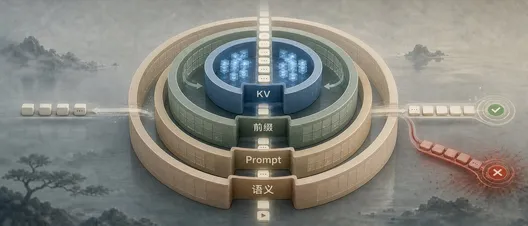
四种 LLM 缓存:省在哪里,错在哪里
Published: at 12:12 AM从 KV、Prefix、Prompt 到 Semantic Cache,讲清四种 LLM 缓存保存什么、何时命中、为何失效,以及生产环境该如何排查成本、延迟与错误命中。
-
RAG 其实没那么复杂:六种检索架构怎么选
Published: at 04:41 AM很多 RAG 项目一开始就上向量库、切块和重排,复杂度先于问题出现。本文拆解六种检索方案,从 BM25 与查询改写开始,按数据新鲜度、查询类型、规模和实测结果选择升级路径,并给出多意图查询与验证清单。
-
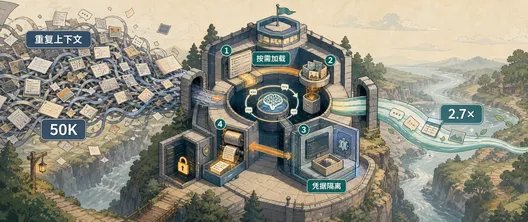
Agent 成本高,先查 Harness
Published: at 08:20 AM同一个模型和任务,Agent 仍可能因为上下文膨胀与工具调用过多而多花几倍 token。本文拆解 Harness 的成本来源,并用 TrueForge 说明延迟加载、结果卸载、子代理、Code Mode 与压缩如何协同。
-
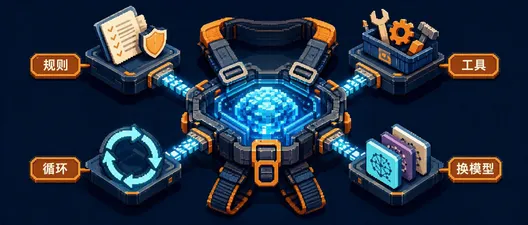
Agent Harness 是什么?模型之外的运行环境
Published: at 12:47 AMAgent Harness 给大模型提供指令、工具、执行循环与模型切换能力。本文用登山安全带和邮件代理的例子讲清四部分,并解释用户为什么能自主运行、换模型并保留本地会话。